SQL – Manual de supervivencia
Es este capítulo, se va a describir las sentencias más importantes del lenguaje estructura de consultas, en un tono y nivel de supervivencia total.
En próximos capítulos ahondaremos en cada sentencia, pero para una primera aproximación y puesta en marcha, este pequeño manual junto a sus prácticas, resultará una buena incursión.
Introducción
SQL (Structured Query Language) es un lenguaje de programación diseñado para gestionar y manipular bases de datos relacionales. Fue desarrollado en los años 70 por IBM y se ha convertido en el estándar para trabajar con bases de datos en prácticamente todas las plataformas.
¿Dónde se utiliza SQL?
SQL se utiliza en una amplia variedad de entornos y aplicaciones, entre ellos:
- Empresas: Para gestionar grandes volúmenes de información (clientes, ventas, productos, etc.).
- Aplicaciones web: Para guardar y recuperar datos de usuarios, publicaciones, mensajes, etc.
- Analítica de datos: Para consultar, agrupar, filtrar y analizar datos estructurados.
- Sistemas de gestión empresarial: Como CRMs, ERPs, y sistemas financieros.
- Big Data y Ciencia de Datos: En combinación con herramientas como Hadoop, Spark o bases de datos en la nube.
Aspectos clave a conocer antes de comenzar
Antes de adentrarse en las sentencias SQL, es importante comprender algunos conceptos básicos:
1. Base de datos
Es una colección organizada de datos. Puede contener múltiples tablas.
2. Tabla
Es la estructura básica donde se almacenan los datos en filas y columnas, similar a una hoja de cálculo. Cada tabla tiene un nombre, y cada columna tiene un tipo de dato (texto, número, fecha, etc.).
3. Registro (fila)
Cada fila representa una entrada individual de datos.
4. Columna (campo)
Cada columna representa un atributo del dato (por ejemplo, "nombre", "edad", "correo").
5. Clave primaria
Es una columna (o combinación de columnas) que identifica de manera única cada fila en una tabla.
6. Relaciones entre tablas
SQL trabaja sobre bases de datos relacionales, donde las tablas pueden estar conectadas mediante claves foráneas, permitiendo consultas complejas y organizadas.
7. Tipos de sentencias SQL
Antes de empezar, es útil conocer las categorías principales de sentencias SQL:
- DDL (Data Definition Language): para definir la estructura de la base de datos (ej. CREATE, ALTER, DROP).
- DML (Data Manipulation Language): para manipular datos (ej. INSERT, UPDATE, DELETE).
- DQL (Data Query Language): para consultar datos (ej. SELECT).
- DCL (Data Control Language): para gestionar permisos (ej. GRANT, REVOKE).
- TCL (Transaction Control Language): para controlar transacciones (ej. COMMIT, ROLLBACK).
Empecemos...
Partimos de una base de datos con esta estructura de tablas:
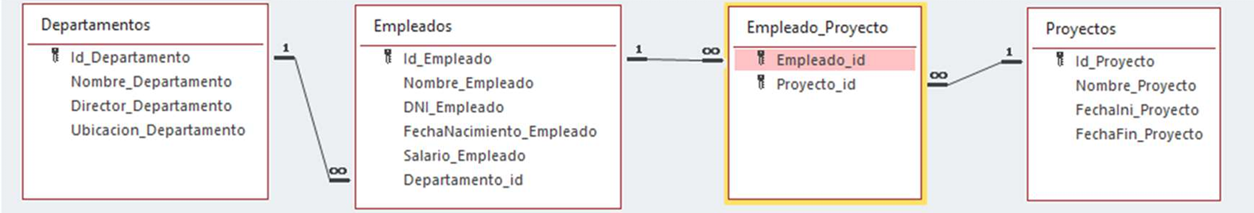
La descripción de las tablas es la siguiente:
- La tabla Departamentos contiene la información relacionada con los departamentos que tiene mi Universidad. En esta tabla se almacena información como el nombre, dirección y ubicación del departamento. La clave principal única de mi tabla es el id_Departameto.
- La tabla Empleados contiene la información de los empleados de mi Universidad. En esta tabla se almacenan los datos del empleado: nombre. Dni, fecha nacimiento, salario y el departamento al que pertenece. Por lo tanto, esta tabla se relaciona con lo de Departamentos, mediante el campo Departamento_id. La clave principal de la tabla es el id_Empleado
- La tabla Proyectos contiene información de proyectos que se han realizado en la Universidad. Únicamente guardamos el nombre del proyecto y el inicio y fin del proyecto. La clave principal es el id_proyecto.
- Como un proyecto puede tener varios empleados, necesitamos una tabla que relacione los empleados con los proyectos, es por eso que se crea la tabla Empleado_Proyecto. La clave principal de esta tabla es la dupla de valores de Empleado_id y de Proyecto_id, además estos valores son clave ajena a las tablas Empleados y Proyectos, respectivamente
Si esta explicación de la base de datos no se entiende póngase en contacto con su tutor para aclarar las dudas antes de comenzar con el resto de temario.
Como hacer consultas -instrucción SQL: SELECT-
Lo primero que vamos a aprender es a realizar consultas en nuestra base de datos, es decir, quiero consultar, recuperar … información almacenada en mi base de datos.
Esta consulta, como se puede imaginar, puede ser desde muy simple (recuperar el id de la tabla empleados), hasta muy compleja involucrando en la sentencia varias tablas o incluso subconsultas.
La sentencia SQL que lo realiza es:
SELECT <<lista de campos a mostrar>> FROM <lista de tablas de la consultas>> WHERE <<lista de condiciones de la consultas>> ORDER BY <<campo por el que ordenar> ASC/DESC
La parte del WHERE y ORDER BY es opcional como se verá en los ejemplos.
En el FROM puede haber una tabla o varias, en este caso hay que establecer la relación entre ambas para no provocar lo que se conoce como producto cartesiano**
**¿Qué es un producto cartesiano en SQL?
Un producto cartesiano es el resultado de una operación de combinación entre dos tablas sin una condición de unión. Esto significa que cada fila de la primera tabla se combina con todas las filas de la segunda tabla, generando una gran cantidad de combinaciones posibles.
Fórmula:
Si la tabla A tiene n filas y la tabla B tiene m filas, entonces el producto cartesiano tendrá n × m filas.
Ejemplo práctico:
Supongamos que tienes estas dos tablas:
Tabla A (Clientes)
ID Nombre
1 Ana
2 Luis
Tabla B (Productos)
ID Producto
1 Portátil
2 Teclado
3 Ratón
Si ejecutas esta consulta sin condición de unión:
SELECT * FROM Clientes, Productos;
El resultado será:
ID Nombre ID Producto
| ID | Nombre | ID | Producto |
|---|---|---|---|
| 1 | Ana | 1 | Portátil |
| 1 | Ana | 2 | Teclado |
| 1 | Ana | 3 | Ratón |
| 2 | Luis | 1 | Portátil |
| 2 | Luis | 2 | Teclado |
| 2 | Luis | 3 | Ratón |
Es decir, 6 filas = 2 clientes × 3 productos.
¿Por qué es importante entenderlo?
- El producto cartesiano no suele ser deseado en la mayoría de los casos.
- Ocurre cuando te olvidas de poner una condición ON o WHERE al hacer un JOIN entre tablas.
- Puede generar resultados muy grandes e ineficientes si las tablas tienen muchas filas.
- Por eso, siempre que hagas una combinación de tablas, asegúrate de usar correctamente los JOINs (INNER, LEFT, etc.) con sus respectivas condiciones o establecer en el WHERE la relación
Consejo para los estudiantes
Cuando veas que una consulta te devuelve más filas de las que esperas al unir tablas, ¡puede que hayas generado sin querer un producto cartesiano!
Ejemplos sentencia SELECT:
SELECT Empleados.Nombre_empleado FROM Empleados;
- Descripción: Esta instrucción selecciona el Nombre del empleado de todos los empleados
- NOTA: Empleados.Nombre_empleado es primero el nombre de la tabla, punto, el campo de la tabla.
- Es útil y necesario para saber a que campo quieres acceder si confusión, es decir, si tuvieras dos tablas distintas que tienen el campo Nombre_empleado, si no pones el nombre de la tabla anteriormente la instrucción fallaría devolviéndote un error como que no sabe que campo mostrar de las dos posibilidades que ha encontrado. Por lo tanto, el poner el nombre de la tabla antes que el campo no es obligatorio hasta cierto punto, pero si una buena practica.
SELECT Empleados.Nombre_Empleado, Empleados.FechaNacimiento_Empleado FROM
Empleados WHERE DNI_Empleado = “23412123H”;
- Descripción: Selecciona el nombre y la fecha de los empleados que cumplan la condición de que su DNI sea 23412123H
➢
SELECT Empleados.Nombre_Empleado, Empleados.FechaNacimiento_Empleado FROM
Empleados WHERE (Empleados.DNI_Empleado = “23412123H” AND
Empleados.FechaNacimiento_Empleado = #11/10/1980# );
- Descripción: Selecciona el nombre y la fecha de los empleados que cumplan la condición de que su DNI sea 23412123H y su fecha de nacimiento sea 11/10/1980
- NOTA: La comparación de un valor de tipo fecha cambia de un sistema de base de datos u otro. En este ejemplo, para Microsoft Access el valor de la fecha tiene que ir en #, pero en otros con Oracle no es necesario.
➢
SELECT Empleados.Nombre_empleado, Departamentos.Nombre_departamento FROM
Empleados, Departamentos WHERE Empleados.Departamento_id =
Departamentos.Id_Departamento;
- Descripción: Selecciona el nombre del empleado y el nombre del departamento. Para ello hay que establecer la relación entre las dos tablas, que como hemos dicho, es a través del campo id_departamento -sino se hiciera sacaría todas las filas de empleados junto todas las filas de departamentos, haría un producto cartesiano-)
SELECT Empleados.Nombre_Empleado, Departamentos.Nombre_Departamento FROM
Empleados, Departamentos WHERE (Empleados.Departamento_id =
Departamentos.Id_Departamento) AND (Empleados.DNI_Empleado = "23412123H" OR
Empleados.Salario_Empleado > 30000);
- Descripción: Selecciona el nombre del empleado y el nombre del departamento, de los Empleados con dni 23412123H o con un sueldo mayo a 30000
- NOTA: En este punto hay que repasar los operadores AND, OR, NOT:
Tabla de verdad de los operadores lógicos en SQL
1. Operador AND (Y lógico)
Devuelve TRUE solo si ambas condiciones son verdaderas.
| Condición A | Condición B | A AND B |
|---|---|---|
| TRUE | TRUE | TRUE |
| TRUE | FALSE | FALSE |
| FALSE | TRUE | FALSE |
| FALSE | FALSE | FALSE |
2. Operador OR (O lógico)
Devuelve TRUE si al menos una de las condiciones es verdadera.
| Condición A | Condición B | A OR B |
|---|---|---|
| TRUE | TRUE | TRUE |
| TRUE | FALSE | TRUE |
| FALSE | TRUE | TRUE |
| FALSE | FALSE | FALSE |
3. Operador NOT (Negación lógica)
Invierte el valor de verdad de la condición.
| Condición A | NOT A |
|---|---|
| TRUE | FALSE |
| FALSE | TRUE |
Ejemplos prácticos:
WHERE Edad > 18 AND Ciudad = 'Madrid'
→ Solo devuelve filas donde ambas condiciones se cumplen.
WHERE Departamento = 'Ventas' OR Departamento = 'Marketing'
→ Devuelve filas que pertenezcan a cualquiera de los dos departamentos.
WHERE NOT (Activo = TRUE)
→ Devuelve los registros con Activo a FALSE.
NOTA: La relación entre tablas puede realizarse de dos maneras (éstos dos ejemplos son equivalentes)
- La vista hasta ahora FROM tabla1, tabla2 WHERE tabla1.id=tabla2.id
- Con JOIN** dentro de la parte del FROM:
FROM tabla1 INNER JOIN tabla2 ON tabla1.id = tabla2.id
**Resumen de tipos de JOIN en SQL
Los JOIN se utilizan para combinar registros de dos o más tablas basándose en una condición común (normalmente una clave foránea).
1. INNER JOIN
Devuelve solo los registros que tienen coincidencia en ambas tablas.
INNER JOIN = JOIN. Pero en Access hay que poner el INNER sí o sí.
Ejemplo:
SELECT *
FROM Empleados
INNER JOIN Departamentos
ON Empleados.ID_Departamento = Departamentos.ID_Departamento;
Resultado:
Solo mostrará los empleados que están asignados a un departamento existente.
2. LEFT JOIN (o LEFT OUTER JOIN)
Devuelve todos los registros de la tabla izquierda, y los registros coincidentes de la tabla derecha.
Si no hay coincidencia, rellena con NULLs.
Ejemplo:
SELECT *
FROM Empleados
LEFT JOIN Departamentos
ON Empleados.ID_Departamento = Departamentos.ID_Departamento;
Resultado:
Muestra todos los empleados, incluso si no tienen departamento asignado.
3. RIGHT JOIN (o RIGHT OUTER JOIN)
Devuelve todos los registros de la tabla derecha, y los registros coincidentes de la tabla izquierda.
Si no hay coincidencia, rellena con NULLs.
Ejemplo:
SELECT *
FROM Empleados
RIGHT JOIN Departamentos
ON Empleados.ID_Departamento = Departamentos.ID_Departamento;
Resultado:
Muestra todos los departamentos, incluso si no tienen empleados asignados.
Tip visual: Comparación rápida
| Tipo de JOIN | Incluye de tabla A | Incluye de tabla B | Resultado |
|---|---|---|---|
| INNER JOIN | Solo si coincide | Solo si coincide | Coincidencias |
| LEFT JOIN | Siempre | Solo si coincide | Todos los de la izquierda |
| RIGHT JOIN | Solo si coincide | Siempre | Todos los de la derecha |
Por lo tanto:
SELECT tabla1.*, tabla2.*
FROM tabla1, tabla2
WHERE tabla1.id = tabla2.id;
Y
SELECT tabla1.*, tabla2.*
FROM tabla1
INNER JOIN tabla2 ON tabla1.id = tabla2.id;
➢
SELECT Empleados.Nombre_Empleado, Departamentos.Nombre_Departamento FROM
Empleados, Departamentos WHERE Empleados.Departamento_id =
Departamentos.Id_Departamento and Empleados.Departamento_id in (SELECT
Departamentos.Id_Departamento FROM Departamentos WHERE Ubicacion_Departamento =
"Campus 1 Sala 123 UPM")
Descripción: Aquí lo único que cambia es la subconsulta que hace para comparar el valor de Empleados.Departamento_id.
Una subconsulta en SQL es una consulta dentro de otra consulta. Se utiliza para obtener un conjunto de datos que luego es usado por la consulta principal.
Se pueden usar en diferentes partes de una consulta, como en la cláusula SELECT, FROM o WHERE.
Otro ejemplo:
SELECT nombre, salario
FROM empleados
WHERE salario > (SELECT AVG(salario) FROM empleados);
SELECT Empleados.Nombre_empleado FROM Empleados ORDER BY Empleados.Nombre_Empleado DESC;
Descripción: Selecciona el nombre del empleado de todos los empleados ordenados por nombre del empleado de forma descendente
Otras instrucciones más complejas son group by y having que veremos en los siguientes temas.
4. FULL JOIN (o FULL OUTER JOIN) (Esta es una mezcla de LEFT JOIN y RIGHT JOIN)
Devuelve todas las filas de ambas tablas, con coincidencias cuando las hay, y NULL cuando no.
SELECT e.nombre, d.nombre
FROM empleados e
FULL JOIN departamentos d ON e.id_departamento = d.id;
Incluye empleados sin departamento y departamentos sin empleados.
5. CROSS JOIN (Esta no se usa nada, solo para pruebas raras de rendimiento, muy omitible)
Devuelve el producto cartesiano: todas las combinaciones posibles entre las filas de ambas tablas.
SELECT e.nombre, d.nombre
FROM empleados e
CROSS JOIN departamentos d;
Si hay 10 empleados y 5 departamentos, genera 50 filas.
6. SELF JOIN
Es un JOIN de una tabla consigo misma. Útil para jerarquías (como empleados que son jefes de otros empleados).
SELECT e1.nombre AS empleado, e2.nombre AS jefe
FROM empleados e1
LEFT JOIN empleados e2 ON e1.id_jefe = e2.id_empleado;
Relaciona empleados con sus jefes.
El ORDEN por defecto de muestra de resultados de consultas es ASC.
ORDER BY campo ASC = ORDER BY campo.
Como hacer inserciones en una tabla -instrucción SQL INSERT-
La sintaxis de la sentencia es:
INSERT INTO nombre_tabla (columna1, columna2, columna3, ...)
VALUES (valor1, valor2, valor3, ...);
Ejemplos:
INSERT INTO Empleados (Id_Empleado, Nombre_Empleado, DNI_Empleado,
FechaNacimiento_Empleado, Salario_Empleado, Departamento_id)
VALUES (114, 'Juan Pérez', "1111111H", #11/12/2020#, 22000, 10);
Descripción: Inserta un empleado con esos datos, pero como hemos dicho que el Departamento_id referencia a un departamento, si no existe el departamento_id 10, esta consulta dará un error y habría que crear antes el departamento:
INSERT INTO Departamentos (Id_Departamento, Nombre_Departamento,
Director_departamento, Ubicacion_Departamento )
VALUES (10, “Informatica”, “Carmen Morales”, “Campus 2 Sala 90 UPM”);
Variantes de esta cláusula:
Insertar múltiples filas:
INSERT INTO nombre_tabla (columna1, columna2, columna3, ...)
VALUES
(valor1, valor2, valor3, ...),
(valor4, valor5, valor6, ...),
(valor7, valor8, valor9, ...);
Insertar datos de otra tabla:
INSERT INTO nombre_tabla_destino (columna1, columna2, ...)
SELECT columna1, columna2, ...
FROM nombre_tabla_origen
WHERE condición;
Ejemplo:
INSERT INTO Empleados_IA (id, nombre, DNI, Fecha, salario)
SELECT Id_Empleado, Nombre_Empleado, DNI_Empleado, FechaNacimiento_Empleado,
Salario_Empleado
FROM Empleados
WHERE Departamento_Id = “IA”;
Descripción: En este caso debe existir la tabla Empleados_IA y se va a rellenar con los valores recuperados en la instrucción SELECT, es decir, a partir de una consulta con SELECT que devuelve unos valores se crea el contenido de otra tabla.
Como hacer actualizaciones en una tabla -instrucción SQL UPDATE-
La sintaxis de la sentencia es:
UPDATE nombre_tabla
SET columna1 = valor1, columna2 = valor2, ...
WHERE condición;
El WHERE es opcional, sino se pusiera se actualizaría todos los registros de la tabla.
Ejemplos:
UPDATE Empleados SET FechaNacimiento_Empleado = #11/04/2020#
WHERE Id_Empleado = 114;
Descripción: Actualiza el campo Fecha Nacimiento a 11/04/2020 del Empleado cuyo id_Empleado es 114
Variantes:
Actualizar varios campos:
UPDATE nombre_tabla
SET columna1 = valor1, columna2 = valor2, ...
WHERE condición;
Actualizar todos los registros:
UPDATE Empleados
SET FechaNacimiento_Empleado = #11/04/2020#;
NOTA: Al quitar el WHERE se actualizaría la Fecha de Nacimiento a todos los Empleados de la tabla
Usar una subconsulta, por ejemplo:
UPDATE Empleados
SET Salario_Empleado = (SELECT AVG(Salario_Empleado) FROM Empleados)
WHERE Departameto_id = 5;
Descripción: Actualiza el salario de los empleados cuyo departamento en el 5, con la media de salario de todos los empleados
NOTA: AVG es una función que te da SQL que te calcula media en este caso de los salarios de la tabla Empleados. Hay más funciones que puedes consultar en la documentación y que veremos en siguientes capítulos MAX, MIN, COUNT…)
Actualización por casos, por ejemplo:
UPDATE Empleados
SET Salario_Empleado = CASE
WHEN Departameto_id = 1 THEN Salario_Empleado * 1.2
WHEN Departameto_id = 2 THEN Salario_Empleado * 1.15
ELSE Salario_Empleado * 1.1
END;
Descripción: Si el departamento es 1 el salario del empleado va a ser el salario que tuviera multiplicado por 1.2, si el departamento es 2 el salario se multiplica por 1.15 y es cualquier otro caso, el salario se multiplica por 1.1
Como borrar un registro -instrucción SQL DELETE-
La sintaxis de la sentencia es:
DELETE FROM nombre_tabla WHERE condición;
Siendo la parte WHERE opcional
Ejemplos:
DELETE FROM Empleados WHERE id_Empleado= 114;
Descripción: Borra el empleado con id de empleado igual a 114
Eliminar múltiples filas:
DELETE FROM Empleados WHERE Departamento_id = 9;
Descripción: Elimina todos los empleados que tenga el id departamento igual a 9
Eliminar todos los registros de una tabla:
DELETE FROM Empleados;
Descripción: No hay clausula WHERE entonces elimina todos los registros. Esto es igual que hacer un
TRUNCATE TABLE Empleados;
Eliminar a través de uso de una subconsulta:
DELETE FROM Empleados
WHERE id_Empleado IN (SELECT id_ Empleado FROM Empleados WHERE
Salario_Empleado < 2000);